En el post anterior descubrimos qué es el SEO y por qué es el megáfono que tu negocio necesita. Ahora toca entender cómo funciona el «oído» de ese megáfono. ¿Cómo es posible que, al escribir cualquier cosa en esa pequeña barra blanca, Google pueda encontrar la respuesta más relevante entre cientos de miles de millones de páginas en menos de un segundo?
¿Es magia? ¿Hay un ejército de personas leyendo webs a toda velocidad? La realidad es aún más fascinante. Es un sistema, un proceso increíblemente eficiente y lógico. Y una vez que entiendes sus tres fases principales, toda tu estrategia de SEO cobrará un nuevo sentido.
Hoy vamos a abrir el capó de Google. Te prometo que al final de este artículo, verás esa simple barra de búsqueda con otros ojos y entenderás exactamente qué tienes que hacer para que tu web se convierta en su mejor amiga. Para explicarlo, vamos a volver a nuestra analogía favorita: Google como la biblioteca más grande del mundo.
El proceso que sigue Google para darte una respuesta se puede resumir en tres grandes pasos:
Rastreo ➔ Indexación ➔ Ranking
Vamos a ver qué significa cada uno.
Fase 1. Rastreo (el descubrimiento de nuevos libros)
Antes de que un libro pueda ser recomendado, el bibliotecario tiene que saber que existe. El rastreo es precisamente eso: el proceso de descubrimiento. Google utiliza un ejército de programas informáticos llamados «arañas» o «Googlebots». Piensa en ellas como unos pequeños robots bibliotecarios incansables que recorren las estanterías de la biblioteca (la web) 24 horas al día.
¿Cómo lo hacen?
Las arañas empiezan en un conjunto de páginas web conocidas y de confianza. Desde ahí, siguen los enlaces (hipervínculos) que encuentran en esas páginas para descubrir nuevas páginas. Y luego siguen los enlaces de esas nuevas páginas, y así sucesivamente, tejiendo una telaraña gigantesca que abarca casi toda la web pública.
Imagina a un robot bibliotecario que empieza en la entrada de la biblioteca. Ve un pasillo (un enlace a una categoría de tu web), lo recorre. Al final del pasillo ve tres puertas (enlaces a tres productos), y entra en cada una de ellas. Dentro de una de esas habitaciones, ve una ventana que da a otra biblioteca (un enlace a otra web) y también va a explorarla. No se detiene nunca.
¿Qué significa esto para ti?
Los enlaces son las carreteras de la web. Si ninguna otra página enlaza a la tuya (ni siquiera tus propias páginas se enlazan entre sí), las arañas de Google tendrán muy difícil encontrarte. Eres una isla sin puentes.
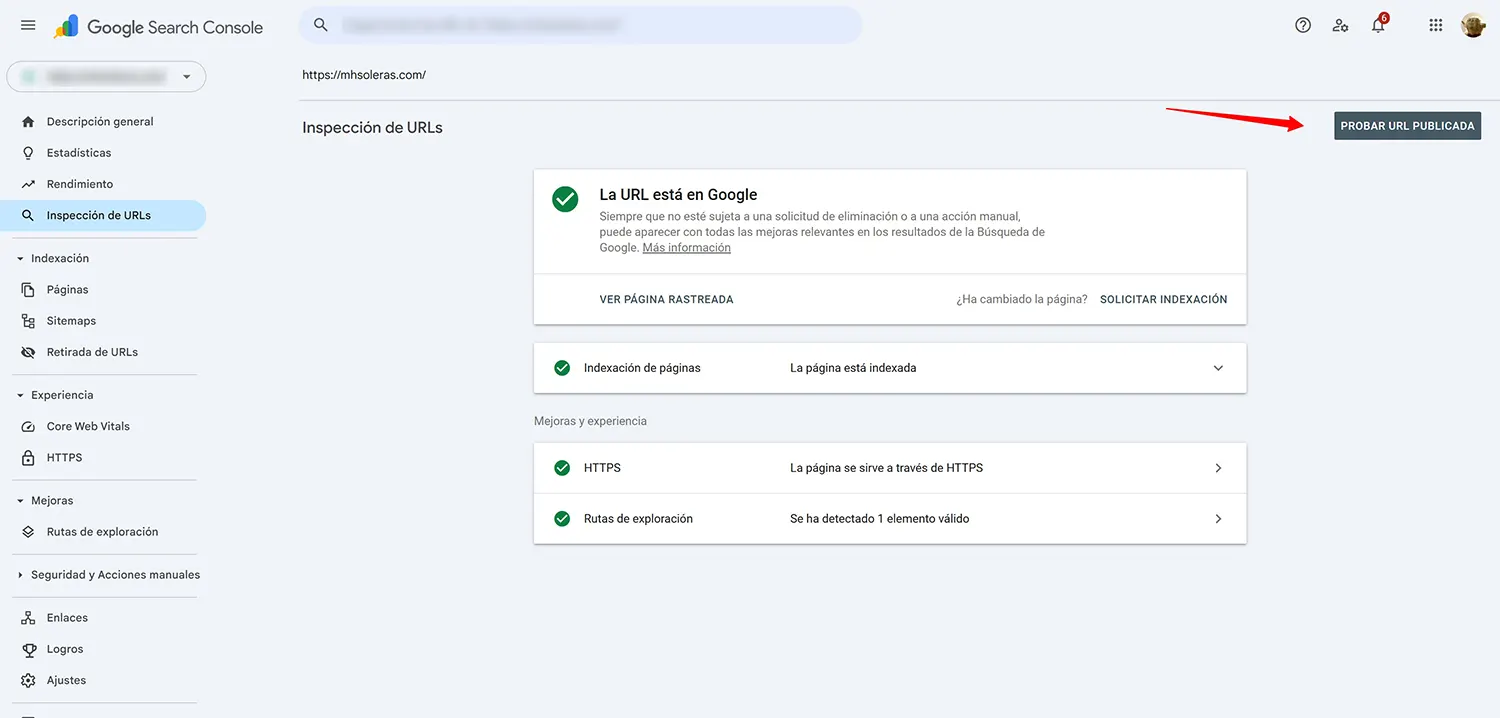
El sitemap.xml es tu mejor aliado. Un sitemap (mapa del sitio) es un archivo que creas en tu web y que contiene una lista de todas tus páginas importantes. Entregarle este mapa a Google a través de Google Search Console es como darle al robot bibliotecario un plano detallado de tu biblioteca para asegurarte de que no se deja ninguna sala importante por visitar.
(No te preocupes por el tema de Google Search Console, lo veremos con detalle más adelante).
Un detalle más: Google no rastrea todo, ni todo el rato. Cada web tiene un ritmo de rastreo que depende de lo rápido que responda el servidor y de lo importante y cambiante que le parezca a Google. Una web pequeña no tiene que preocuparse por esto, pero si tu servidor es lento o da errores, Google visitará menos páginas.
Fase 2. Indexación (el análisis y almacenamiento)
Una vez que la araña de Google ha descubierto una de tus páginas (un libro), no se limita a anotar su título. Ahora empieza la fase de análisis: la indexación. Indexar no es solo guardar. Es procesar, entender y clasificar el contenido de esa página.
En esta fase, Google analiza:
- El texto: lee cada palabra para entender el tema principal.
- Los elementos clave: identifica jerarquía de títulos (<h1>), los subtítulos (<h2>, <h3>), las listas, las palabras en negrita… todo lo que le da pistas sobre la estructura y las ideas importantes.
- Las imágenes y vídeos: analiza los nombres de los archivos y el texto alternativo (etiqueta ALT) para entender de qué tratan.
- La estructura general: ¿La página es fácil de leer? ¿Está bien organizada?
- Lo que se carga con JavaScript: Google «pinta» la página como lo haría un navegador para ver también el contenido que no está en el HTML inicial. Funciona, pero tarda más y a veces falla, así que lo importante conviene que esté en el HTML desde el principio.
También decide si la página es un duplicado de otra. Si encuentra varias versiones casi iguales (con y sin www, con parámetros, versiones para imprimir…), elige una como principal, la «canónica», y es la única que mostrará.
Toda esta información se almacena en una base de datos gigantesca llamada el Índice de Google. Esta es, en esencia, la memoria de la biblioteca, un catálogo colosal que contiene una ficha detallada de cada libro que ha leído.
Nuestro robot bibliotecario ha encontrado tu libro. Ahora, lo abre y lo lee por completo. Anota en una ficha: «Tema principal: Recetas de tarta de queso. Ingredientes clave: queso crema, galletas, mantequilla. Incluye un vídeo paso a paso y 5 fotos del resultado. Está muy bien estructurado en ‘Ingredientes’, ‘Pasos’ y ‘Consejos'». Luego, archiva esta ficha en el gran catálogo de la biblioteca.
¿Qué ocurre después de todo esto?
Que Google rastree una página no significa que la vaya a indexar. Si la ve flojita, repetida o poco útil, puede descartarla: en Search Console lo verás como «Rastreada: actualmente sin indexar». Por eso es tan importante que el contenido sea claro y valga la pena, con títulos descriptivos, buena estructura y nada de muros de texto ilegibles. Y al revés: también puedes pedirle a Google que no indexe algo que no necesitas.
A veces, tienes páginas que no quieres que aparezcan en los resultados de búsqueda (por ejemplo, una página de «gracias por comprar» o borradores). Usando una simple etiqueta (meta robots noindex), puedes poner una señal de «No molestar, privado» en ese libro, y el bibliotecario, amablemente, no lo incluirá en su catálogo público.
Fase 3. Ranking (la recomendación del mejor libro)
Aquí es donde ocurre la verdadera «magia». Esta es la culminación de todo el proceso. Un usuario llega a Google y escribe una consulta. En ese instante, Google acude a su gigantesco índice y se pregunta: «De todos los miles de libros que he leído y analizado sobre este tema, ¿Cuál es el mejor para este usuario en este preciso momento?».
La respuesta a esa pregunta la da el algoritmo de Google. Es una fórmula secreta y extremadamente compleja, con cientos de factores y señales, que decide el orden de los resultados. Aunque nadie conoce la receta exacta, sí conocemos los ingredientes principales.
Para decidir el ranking, el algoritmo (nuestro sabio jefe de biblioteca) se hace preguntas como:
- Relevancia y significado: ¿Esta página responde exactamente a la pregunta del usuario? Analiza las palabras clave, pero sobre todo, el significado semántico y la intención de búsqueda. ¿El usuario quiere comprar, aprender o comparar?
- Calidad del contenido: ¿El contenido es útil, completo, original y bien escrito? ¿Aporta un valor real o es superficial y copiado?
- Autoridad de la fuente (E-E-A-T): ¿Este «libro» ha sido recomendado (enlazado) por otras webs importantes y de confianza? ¿El autor es un experto reconocido en la materia? Esto es el famoso concepto de E-E-A-T que vimos en la guía principal.
- Experiencia de usuario: ¿La página carga rápido? ¿Se ve bien en un teléfono móvil (mobile-friendly)? ¿Es segura (https://)? ¿Los usuarios pueden navegar por ella fácilmente?
- Contexto del usuario: ¿Desde dónde está buscando el usuario (para búsquedas locales)? ¿Cuál es su historial de búsqueda? ¿Qué idioma habla?
Combinando las respuestas a todas estas preguntas en una fracción de segundo, Google ordena los resultados y te los presenta en la página, con el que considera el mejor de todos en la primera posición.
En muchas búsquedas, además, Google añade arriba del todo un resumen generado con IA (los AI Overviews), que se construye a partir de esas mismas páginas que tiene indexadas y bien valoradas, y las cita con enlace. Así que las tres fases siguen siendo la puerta de entrada: si no te rastrea, no te indexa y no te valora, tampoco te citará.
Ahora ya conoces el proceso de tres pasos que sigue Google. No es magia, es un sistema muy sofisticado.
- Rastreo: te descubren a través de los enlaces.
- Indexación: analizan y entienden tu contenido.
- Ranking: te clasifican según tu relevancia y autoridad.
¿Cuál es tu trabajo?
Es simple en teoría, aunque requiere dedicación en la práctica:
- Para ser rastreado: asegúrate de que tu web tiene una buena estructura de enlaces internos y consigue que otras webs te enlacen.
- Para ser indexado: crea contenido claro, estructurado y de calidad que Google pueda entender sin esfuerzo.
- Para conseguir un buen ranking: conviértete en la mejor respuesta posible para tus usuarios. Sé el más útil, el más experto y el más fiable.
Ahora que ya conoces el proceso, el siguiente paso es empezar a hablar el mismo idioma que los profesionales del SEO. Hay una serie de términos que oirás una y otra vez. ¿SERP? ¿CTR? ¿Backlink? En el próximo post, te daré el diccionario definitivo.
¿Preparado para aprender el lenguaje del SEO? Continúa aquí: Diccionario SEO: 25 términos clave explicados.
¿Te parece un sistema complejo de navegar? Lo es. Si prefieres que un piloto experto en SEO tome los mandos de tu estrategia, contacta conmigo. Y si quieres ver todos los fundamentos del SEO que vamos a seguir, echa un vistazo a esta guía.